Inkling 2 Mini 已于 11 月 20 日开源。官方称它可在笔记本本地运行,总参数 264 亿、激活 34 亿,权重约 20GB,许可为 Apache 2.0。
发布时间和获取途径
Thinking Machines Lab 的新闻稿与模型卡都将发布日期写为 2026 年 11 月 20 日。权重在 Hugging Face 仓库 thinkingmachines/Inkling-2-Mini 下载,许可为 Apache 2.0。同一天还放出研究用可变循环检查点 thinkingmachines/TML-d24-varloop-research,方便比较不同循环次数。官方平台 Tinker 已提供推理和定制;模型卡还写明,第三方推理服务也可通过 API 访问该模型。
本地运行方面,官方提供了 llama.cpp 的 GGUF 量化,包括 4 比特(IQ4_NL)和 8 比特(Q8_0),仓库为 ggml-org/Inkling-2-Mini-GGUF。模型卡建议:苹果芯片可尝试 Ollama 或 Exo Labs;NVIDIA 一侧列出了 SGLang、vLLM、Unsloth 等框架。Hugging Face 配套博文还写明,已支持 Transformers、Llama(llama.cpp)和 MLX。
循环架构和规格
Inkling 2 Mini 是 24 层解码器 Transformer,采用稀疏混合专家(MoE):每层把 token 路由到 128 个专家中的 8 个。中间 12 层会用同一套权重循环运行 3 次,因此 24 层权重要被应用 48 次。基础激活 34 亿,三次循环后有效激活约为 54 亿。官方称,这样可以在少写思维链的情况下多做推理,尤其有利于依赖推理质量的智能体编程任务。
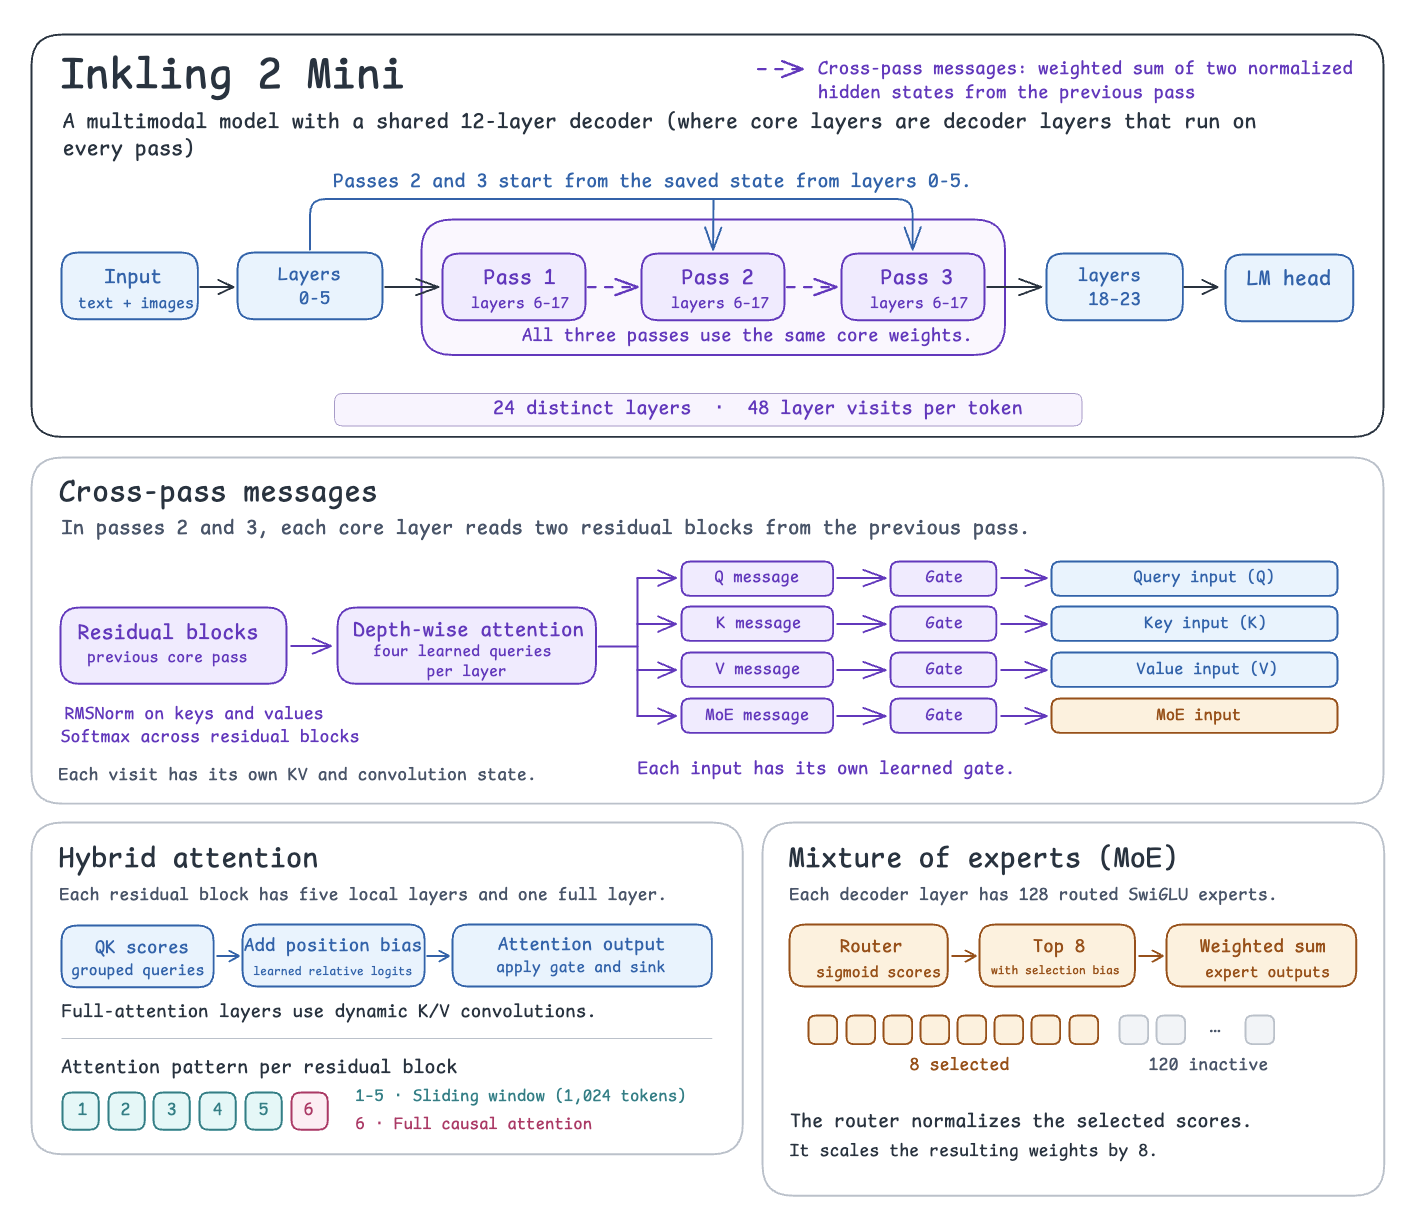
它是原生多模态模型,接受文本和图像,输出文本,上下文最长 100 万 token。多数权重量化并部署为 NVFP4,最后四层为 MXFP8,整体约占 20GB。官方列出的本地硬件包括:内存不少于 32GB 的苹果芯片设备(MacBook、Mac mini、Studio)、一块 NVIDIA DGX Spark,以及其他建议显存不少于 32GB 的 GPU。官方演示中,研究人员在飞机模式下,用 MacBook Pro(M5 Pro,48GB 内存)离线运行该模型,并在几分钟内写出了一个可操作的飞行模拟器。这只能说明它可以本地离线工作,并不代表所有 32GB 设备都有同样速度。
官方评测要点
官方新闻稿写明:在总参数不足 1000 亿的开源权重模型中,Inkling 2 Mini 在 DeepSWE v1.1(48.2%)和 Vals Index v2.2(46.5%)等基准上领先。下表摘自官方对照,评测设置因模型而异,本站未另行实测。
| 项目 | Inkling 2 Mini | Qwen3.8-27B | Nemotron 3.5 Super VL |
|---|---|---|---|
| 激活 / 总参数(十亿) | 5.4 / 26.4 | 27.0 / 27.0 | 12.0 / 124.5 |
| AA Index v5.0 | 20.1 | 20.1 | 13.6 |
| Vals Index v2.2 | 46.5% | — | 29.8% |
| DeepSWE v1.1 | 48.2% | 42.2% | 24.7% |
| SWE-bench Pro v2 Hard | 77.9% | 73.8% | 44.1% |
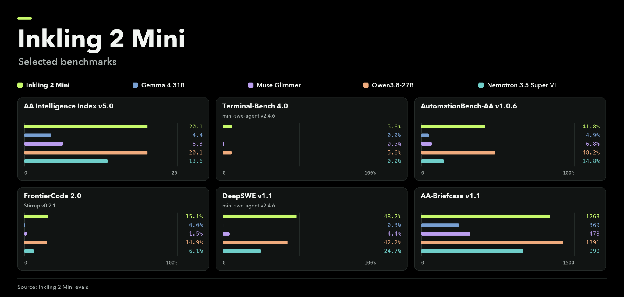
官方同时提醒:循环能提升推理,但不会让权重记住更多事实,知识大体仍取决于总参数量。它在 AA-Omniscience 等事实性指标上与同规模模型相当,更依赖搜索和工具来补差距;在 BrowseComp、DeepSearchQA、MCP Atlas 等带工具的任务上,同规模开源模型中表现靠前。对照表里的 Qwen3.8-27B 与它在 AA Index 上同为 20.1;本站此前介绍过同系列后续的 Qwen4-Max 发布与 API 定价,二者不是同一代型号,不宜直接比分。
可变循环模型的实验显示:在 Think Fast 基准上,不写思维链、以人类完成该任务所需时间计量的 50% 可靠时间跨度,从 1 次循环的 16 秒提高到 3 次循环的 37 秒;在需要串行推理的查找任务上,效果一直改善到 10 次循环(训练时最多只见到 5 次)。思维链会随循环变短,但仍可读。官方称,增加循环并未使智能体破坏类测试的分数走高。细节见新闻稿和模型卡。
Tinker 定价与使用注意
开源权重要自行准备算力。2026 年 11 月 22 日查阅的 Tinker 定价页上,Inkling 2 Mini 的采样为每百万 token 0.50 美元,预填充 0.15 美元,缓存预填充 0.015 美元;训练为 64K 档 0.75 美元、256K 档 1.50 美元。文档写明这两档的采样上下文均可到 100 万 token。页内表格备注写有“as of October 19, 2026”,但该型号已作为 New 列出,具体以页面实时标价为准。Tinker 的 Serverless inference 仍在测试,目前只列了 Inkling 2 Small、Inkling 和 Inkling-Small,并不包括 Inkling 2 Mini,不要把采样价理解成已上线的无服务器推理价。
模型卡还写了几条部署限制:它在多数评测上弱于更大的 Inkling 2 Small,差距主要在事实回忆,更可能自信地给出错误信息;调试代码时有时会陷入重复推理,官方建议限制输出 token 和智能体轮数;使用工具时,可能在未确认的情况下删除或覆盖文件,智能体任务应放在沙箱里,并对不可逆操作要求确认。语言方面,模型卡把英语和其他语言都列入意图用途,但在中文测试中观察到过截断的措辞和中英混杂,不能默认中文表现与英文评测一致。把推理强度调到最低并不能完全关闭推理;中间层固定跑 3 次,每枚 token 的计算量高于只看激活参数时的印象。本地运行时,循环架构的运行时支持仍新,速度会因框架和硬件而异。
如果需要的是体量更大、偏云端部署的开源旗舰,本站此前写过 腾讯 Hy4 的发布说明 ,以及 美团 LongCat-2.5。它们和 Inkling 2 Mini 面向的硬件档位不同,不能互相替代。
常见问题
普通笔记本能不能本地运行?
官方给出的权重体积约 20GB,并写明可在内存不少于 32GB 的苹果芯片设备上运行;演示用的是 48GB 内存的 MacBook Pro(M5 Pro)。32GB 是官方列出的门槛,实际速度要以量化格式和推理框架为准。本站未在本地实测。
它和 Inkling 2 Small 是什么关系?
Inkling 2 Mini 是该系列中最小、面向笔记本的一款,官方称其能力侧重点与 Inkling 2 Small 相近,擅长长程智能体任务。模型卡明确写了它在多数评测上弱于 Small,尤其是事实性问答。
中文效果能达到英文评测那样吗?
不能直接这样假定。模型卡把多语言列入意图用途,但单独说明:中文测试中出现过截断和中英混杂。若主要工作语言是中文,应先用自己的任务做验证。
本地和 API 的接入步骤,见同期教程 Inkling 2 Mini 接入配置教程:本地与 API。
信息来源
- Thinking Machines Lab 官方新闻:Introducing Inkling 2 Mini(2026-11-20)
- Thinking Machines Lab 官方模型卡:Inkling 2 Mini
- Thinking Machines Lab 官方介绍页:Inkling 系列
- Hugging Face 模型仓库:thinkingmachines/Inkling-2-Mini
- Hugging Face 官方博文:Welcome Inkling 2 Mini
- Tinker 官方定价页
- Tinker 官方文档:Models & Pricing
核实时间:2026-11-22(Asia/Shanghai)。发布时间、规格、评测分数和 Tinker 标价均据上述官方页面整理,未另行实测。


 微信扫码关注「狠活 AI」


