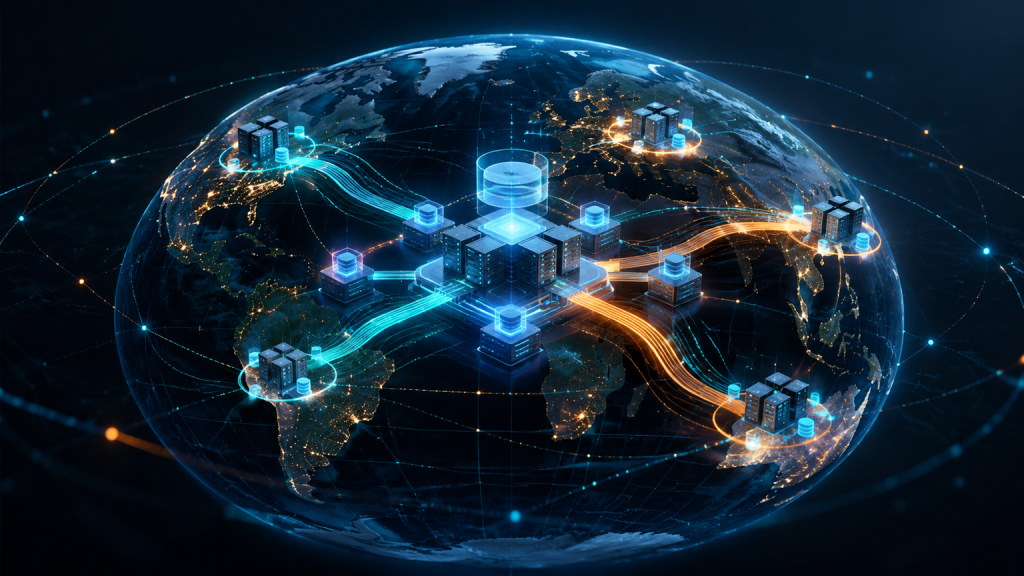
OpenAI 发布 Habitat 在线存储扩展经验的第二部分,披露该系统已面向超过 10 亿 ChatGPT 用户提供存储服务。官方给出的关键信息包括可靠多租户、全球缓存,以及与 Azure Cosmos DB 的组合;其中,读取速度提升 12 倍。对生成式 AI 产品而言,这说明竞争压力已不只落在模型推理,也落在支撑海量会话、偏好与应用状态访问的存储层。
这份工程更新的价值,在于 OpenAI 首次将 ChatGPT 超大用户规模与存储架构改造直接关联。12 倍读取性能提升并不等同于 ChatGPT 所有请求都提速 12 倍,但它表明,存储读路径已经是影响产品响应与服务成本的关键环节。
从模型服务走向存储系统扩容
OpenAI 此次发布的内容属于公司动态与 AI 基础设施工程进展。Habitat 被用于在线存储扩展,服务对象是超过 10 亿 ChatGPT 用户。官方摘要没有公布 Habitat 承载的数据种类、日请求量、写入性能、节点分布或成本数据,因此不能据此推断其完整的数据库替换范围,也不能将 12 倍读取速度直接外推为端到端产品延迟的同等改善。
不过,公开信息已经明确了改造重点:系统需要同时解决规模、隔离性与跨地域访问效率。OpenAI 采用可靠多租户架构,意味着不同租户或业务单元可在共享基础设施中获得隔离和可靠性保障;全球缓存则把高频读取尽量放在靠近访问者的位置,减少跨地域访问存储后端的次数;Azure Cosmos DB 承担的角色,则与底层数据读取能力提升直接相关。
12 倍读取提速为何比单纯扩容更关键
第一,超大规模 AI 产品的瓶颈并不总在 GPU。用户每次打开历史对话、加载工作区内容、读取个性化设置或调用依赖状态的功能,都可能触发存储访问。模型推理即使足够快,若这些前置或并行读取路径波动明显,用户仍会感受到响应迟缓。Habitat 将读取性能作为公开指标,反映出存储正在成为 AI 产品体验链路的一部分。
第二,缓存和数据库优化的组合比单独堆叠计算资源更具工程针对性。全球缓存可处理重复、热点或可复用的读取请求,数据库侧优化则应对需要回源的数据访问。二者配合的目标,不只是把某一次读取做快,而是在用户量继续增长时减少后端被热点流量反复击穿的风险。官方尚未公布缓存命中率、数据一致性策略及故障切换细节,这些仍是评估系统成熟度的重要信息。
多租户能力将影响 AI 产品的企业化边界
可靠多租户架构的意义,超过了基础设施的资源利用率。ChatGPT 正从面向个人的通用助手,进入团队、组织与业务系统的使用场景。此类场景通常要求不同用户、团队或客户之间具备明确的数据边界,并要求在高峰流量下避免相互影响。存储层能否提供可靠隔离,直接关系到产品能否稳定承载更多组织级工作负载。
这也是此次信息中第二个更具行业价值的判断:AI 应用的规模化不只是“更多用户调用同一个模型”,而是“更多用户持续保存、读取和更新各自的应用状态”。当会话、记忆、文件引用、权限和协作内容不断累积,存储架构会从模型服务的配套设施,变成决定产品可靠性、响应速度与运营复杂度的核心系统。
云数据库合作折射基础设施分工
OpenAI 在官方摘要中点名 Azure Cosmos DB,并将其与 12 倍读取性能提升关联。这并不能证明性能提升完全来自单一数据库产品:多租户设计、缓存策略、数据模型和访问路径改造都可能共同作用。但该案例说明,在全球化 AI 应用中,数据库能力需要与缓存、路由和应用层架构协同设计,单一组件的理论性能很难独立决定用户体验。
对云服务商而言,AI 工作负载也在提出不同于传统互联网应用的要求。一方面,用户与智能体交互会产生高频、碎片化且高度个性化的状态读取;另一方面,应用需要在延迟、可靠性、隔离性与跨区域一致性之间做取舍。谁能把这些能力以可运营、可扩展的方式交付,谁就更可能进入下一阶段 AI 应用的底层技术栈。
后续应关注哪些未披露问题
OpenAI 后续若继续披露 Habitat 的工程细节,最应关注的不是更多笼统的规模表述,而是几个可验证问题:12 倍提升对应的具体读取场景和统计口径是什么;全球缓存如何处理失效与一致性;多租户之间采用何种隔离模型;在区域故障或流量突增时,系统如何降级和恢复。
此外,超过 10 亿 ChatGPT 用户描述的是 Habitat 所服务的产品规模,不能自动等同于某一时间点的活跃用户、付费用户或企业客户数量。OpenAI 本次摘要未公布这些拆分指标,也未披露 Habitat 的成本变化。对于外部观察者而言,真正值得跟踪的是 OpenAI 能否持续把存储层效率转化为更稳定的产品体验,以及这种架构是否会成为其面向企业和开发者提供服务的长期底座。
信息来源
- OpenAI,Rapidly scaling online storage to serve over 1 billion ChatGPT users (Part II),2026 年 10 月 24 日,https://openai.com/index/scaling-storage-one-billion-users-part-two
- 本文关于系统定位、用户服务规模与 12 倍读取性能的信息,均依据上述 OpenAI 官方页面摘要;未公开的架构细节均未作事实性推断。


