Inkling 2 Mini 接入配置教程 按官方文档即可完成:苹果芯片可用 Ollama 或 MLX,跨平台用 llama.cpp 的 GGUF,服务端可用 SGLang 或 vLLM;不想本机跑,则走 Tinker 的 OpenAI 兼容接口。
本站上午已介绍过 Inkling 2 Mini 开源与规格。本文只整理官方接入步骤,不涉及第三方中转。若要把本地服务接到 Codex,可对照 Codex 接入 Ollama 本地模型的配置方法。核实时间 2026-11-22(Asia/Shanghai),本文未在本地逐项实测。
接入前先确认
- 官方权重仓库是
thinkingmachines/Inkling-2-Mini,许可 Apache 2.0,检查点约 20GB,采用 NVFP4 与 MXFP8 混合精度。它接受文本和图像,输出文本,上下文最长 100 万 token。 - 硬件以官方模型卡为准:内存不少于 32GB 的苹果芯片设备(MacBook、Mac mini、Studio)、一块 NVIDIA DGX Spark,以及其他建议显存不少于 32GB 的 GPU。演示用过 48GB 内存的 MacBook Pro(M5 Pro),32GB 只是官方列出的门槛,速度要因量化格式和框架而异。
- 按场景选路径:日常对话可先用 Ollama;要控制量化或提供本地 OpenAI 兼容接口,用 Llama App 或 llama.cpp;写脚本可用 Transformers 或 MLX;机房部署用 SGLang 或 vLLM;不部署本机服务则用 Tinker。
- 官方提醒:把推理强度调到最低并不能完全关闭循环,中间 12 层仍固定跑 3 次;使用工具时可能在未确认的情况下改写文件,智能体任务应放在沙箱里。模型卡还写明,中文测试中出现过截断和中英混杂。
| 路径 | 更适合 | 官方入口 | 权重体积(官方) |
|---|---|---|---|
| Ollama | 苹果芯片,上手最快 | ollama run inkling-2-mini |
Ollama 库页写 20GB |
| llama.cpp / Llama App | 跨平台本地服务 | ggml-org/Inkling-2-Mini-GGUF |
IQ4_NL 17.6GB,Q8_0 27.8GB |
| Transformers / MLX | 开发调试、苹果 MLX | thinkingmachines/Inkling-2-Mini |
原始检查点约 20GB |
| SGLang / vLLM | NVIDIA 等服务器部署 | 官方镜像或文档中的启动命令 | 原始检查点约 20GB |
| Tinker API | 不在本地加载权重 | 型号 thinkingmachines/Inkling-2-Mini |
无需本地下载 |
用 Ollama 在苹果芯片上运行
官方模型卡把 Ollama 列为苹果芯片上的推荐软件。Ollama 模型库页给出的启动命令是:
ollama run inkling-2-mini库页将 inkling-2-mini:latest 标为 20GB、100 万上下文,输入支持文本和图像。同一页还列出 26b-a5b 与 26b-a5b-nvfp4 标签,体积同样写为 20GB。拉起之后,可用官方示例调用本机接口:
curl http://localhost:11434/api/chat \
  -d '{"model":"inkling-2-mini","messages": [{"role":"user","content":"Hello!"}]
  }'
Ollama 库页还提供了交给客户端的命令,例如 ollama launch claude --model inkling-2-mini,以及 OpenCode、OpenClaw 的同类命令。本地服务起来后,可再按 OpenCode 接入 API 教程 填写地址和型号。
用 llama.cpp 或 Llama App 加载官方 GGUF
Hugging Face 官方博文写明,发布时提供了 4 比特(IQ4_NL)和 8 比特(Q8_0)量化,仓库为 ggml-org/Inkling-2-Mini-GGUF。同一团队的 Llama App 可在 macOS 菜单栏或 Windows 托盘里管理模型,并提供本地 OpenAI 兼容接口。若在 Linux 上,或希望用命令行提供服务,官方给出的固定循环模型命令是:
llama serve -hf ggml-org/Inkling-2-Mini-GGUF:IQ4_NL要换成 8 比特,把后缀改成 :Q8_0。可变循环检查点对应 ggml-org/TML-d24-varloop-research-GGUF:IQ4_NL。官方体积为 IQ4_NL 17.6GB、Q8_0 27.8GB、BF16 52.2GB,视觉编码器 mmproj 另有 642MB / 346MB 两档。请使用已支持该循环架构的当前版本,过旧构建可能无法加载。
用 Transformers 或 MLX 加载官方权重
Hugging Face 官方博文用 AutoModelForMultimodalLM 加载固定循环模型,核心示例如下:
import torch
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "thinkingmachines/Inkling-2-Mini"

processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id)

messages = [{"role": "user", "content": [{"type": "text", "text": "Why is the sky blue?"}]}]

inputs = processor.apply_chat_template(messages, tokenize=True, add_generation_prompt=True, return_dict=True, return_tensors="pt",).to(model.device)
input_len = inputs["input_ids"].shape[-1]

outputs = model.generate(**inputs, max_new_tokens=1024)
print(processor.decode(outputs[0][input_len:], skip_special_tokens=False))
若要读图,把 messages 换成同时包含图片和文本的列表,路径按官方示例写成 {"type": "image", "image": "/path/to/image.jpg"}。推理强度通过 reasoning_effort 传入 apply_chat_template,默认是 high(0.9),也可使用 none 到 max 这些档位,或 0.0 到 0.99 的数值。可变循环研究检查点为 thinkingmachines/TML-d24-varloop-research,可用 text_config={"loop_num_passes": 2} 改循环次数。
苹果芯片上,官方已把多模态支持合入 mlx-lm,也可直接加载原始检查点并保留 NVFP4 与 MXFP8。官方给出的命令示例为:
mlx_lm generate --model thinkingmachines/Inkling-2-Mini --image image.jpg --prompt "Describe this image.<|end_message|><|message_user|><|content_image|><|unused_200054|>" -m 1000提示词里的特殊标记来自官方博文,请按原文保留,不要自行删改。
用 SGLang 或 vLLM 部署服务
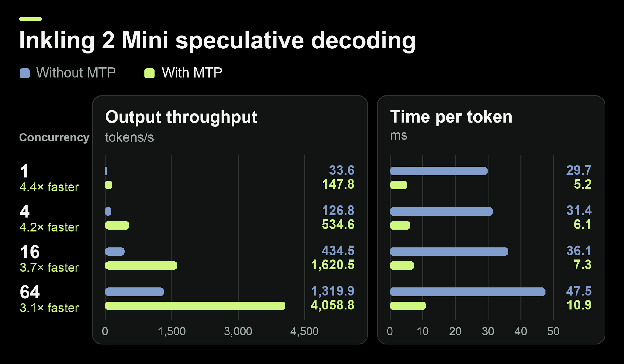
服务端不要用尚未包含该型号的稳定发行版硬跑。SGLang 官方菜谱写明:支持还没进入正式发行版,应安装对应的拉取请求,或使用镜像 lmsysorg/sglang:inkling-2-mini。菜谱验证过 B300 / GB300、H200、RTX 5090 和 DGX Spark 等硬件;RTX 5090(32GB)会把上下文下调到 65536,开启 DSpark 时为 32768。启动参数以官方菜谱为准。博文中的调用示例如下:
curl -s localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"inkling","messages": [{"role":"user","content":"What is 17 times 24?"}],"max_tokens": 512,"reasoning_effort":"low"}'
需要图像输入时,菜谱会加上 --enable-multimodal。若带有 DSpark 草稿权重,官方博文写明可加上 --speculative-algorithm DSPARK --context-length 131072。上图来自官方博文,测试条件是单张 NVIDIA B300、提示和生成各 1024 token,本站未复现。
vLLM 官方菜谱要求 0.35.0 或更高,并写明在该型号进入正式发行版之前,使用镜像 vllm/vllm-openai:inkling-2-mini。官方给出的启动示例为:
docker run --gpus all \
  --privileged --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:inkling-2-mini thinkingmachines/Inkling-2-Mini \
  --tensor-parallel-size 1 \
  --reasoning-parser inkling \
  --speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"probabilistic"}'
服务起来后,把 OpenAI SDK 的 base_url 指到 http://localhost:8000/v1,model 写 thinkingmachines/Inkling-2-Mini。菜谱写明已在 GB200、B300、H100、H200 和 DGX Spark 等平台验证;在 H100 和 DGX Spark 上,上下文会被限制到 262144 token 以便放入显存。
用 Tinker API 远程调用
不想在本地加载约 20GB 权重时,可用 Tinker。在控制台创建密钥并写入 TINKER_API_KEY,或按官方快速入门执行 uv run tinker auth login。OpenAI 兼容接口(Beta)地址为 https://tinker.thinkingmachines.dev/services/tinker-prod/oai/api/v1,64K 训练 / 100 万采样档的型号是 thinkingmachines/Inkling-2-Mini,256K 训练档为 thinkingmachines/Inkling-2-Mini:peft:262144。示例:
from os import getenv
from openai import OpenAI

client = OpenAI(
    base_url="https://tinker.thinkingmachines.dev/services/tinker-prod/oai/api/v1",
    api_key=getenv("TINKER_API_KEY"),
)
response = client.chat.completions.create(
    model="thinkingmachines/Inkling-2-Mini",
    messages=[{"role": "user", "content": "What is 17 * 23?"}],
    reasoning_effort="high",
)
print(response.choices[0].message.content)
也可用 curl,把密钥放在 Authorization: Bearer $TINKER_API_KEY 里。只想先试用,可打开官方的 Tinker Playground。2026 年 11 月 22 日查阅的定价页上,该型号采样为每百万 token 0.50 美元,预填充 0.15 美元,缓存预填充 0.015 美元;训练为 64K 档 0.75 美元、256K 档 1.50 美元。Tinker 的 Serverless inference 仍在测试,名单里还没有 Inkling 2 Mini,不要把采样价理解成已上线的无服务器推理价。
常见报错与解决
内存或显存不足,模型加载失败
先对照官方门槛:苹果芯片建议统一内存不少于 32GB,其他平台建议显存不少于 32GB。官方 8 比特 GGUF 为 27.8GB,32GB 设备还要给系统和上下文留余量;更紧时应优先用官方 IQ4_NL(17.6GB)。
llama.cpp 无法识别模型或循环架构
确认加载的是 ggml-org/Inkling-2-Mini-GGUF,并且 llama.cpp 或 Llama App 已支持该循环结构。版本过旧时,换成当前官方构建后再启动 llama serve。
SGLang 或 vLLM 启动失败
不要使用尚未包含该型号的稳定发行版。SGLang 应使用 lmsysorg/sglang:inkling-2-mini;vLLM 应使用 vllm/vllm-openai:inkling-2-mini,并加上 --reasoning-parser inkling。硬件和上下文上限以官方菜谱为准,例如 RTX 5090 会被主动下调。
Tinker 返回 401,或提示没有权限
确认环境变量 TINKER_API_KEY 已设置且未被撤销,请求发到官方文档中的 base_url,不要把密钥写进前端。型号必须写成 Tinker ID,例如 thinkingmachines/Inkling-2-Mini,不要改用尚未对 Mini 开放的 Serverless 推理名称。
reasoning_effort 返回 400
Tinker 文档写明:若传入模型不接受的推理强度,会返回 HTTP 400,并在错误信息里列出可用值。Thinking Machines 的型号接受 none 到 max 这些字符串,或 0.0 到 0.99 的数值,默认 0.9。用原生 HTTP 时,把 reasoning_effort 放在 JSON 顶层,不要包在 extra_body 里,否则服务端会忽略它。
智能体改动了本地文件,或中文回复被截断
这是模型卡写明的限制。工具调用应在沙箱中进行,并对删除、覆盖等不可逆操作要求确认;若主要使用中文,先用自己的任务验证,不要默认中文表现与英文评测一致。
常见问题
32GB 笔记本能不能直接跑官方 20GB 权重?
官方把内存不少于 32GB 的苹果芯片设备列为可运行条件,演示用的是 48GB 的 MacBook Pro。32GB 是门槛,不是对所有量化和上下文长度的保证;可先用 Ollama 或官方 IQ4_NL,并控制上下文。本站未在本地实测。
Ollama、llama.cpp 和原始检查点有什么差别?
原始检查点保留官方的 NVFP4 与 MXFP8,MLX 也可直接加载。llama.cpp 的官方 GGUF 是量化版,IQ4_NL 和 Q8_0 体积不同;Ollama 库页把 inkling-2-mini 标为 20GB,具体格式以当前标签为准。
不部署本地服务,能不能只走 API?
可以。用 Tinker 的 OpenAI 兼容接口,型号写 thinkingmachines/Inkling-2-Mini,或在 Playground 里试用。不要把它和仍在测试、且尚未列出 Mini 的 Serverless inference 混为一谈。规格、评测和定价见上午的 Inkling 2 Mini 开源说明。
信息来源
- Thinking Machines Lab 官方模型卡:Inkling 2 Mini
- Hugging Face 模型仓库:thinkingmachines/Inkling-2-Mini
- Hugging Face 官方博文:Welcome Inkling 2 Mini
- Hugging Face GGUF 仓库:ggml-org/Inkling-2-Mini-GGUF
- Ollama 官方模型库:inkling-2-mini
- SGLang 官方菜谱:Inkling-2-Mini
- vLLM 官方菜谱:thinkingmachines/Inkling-2-Mini
- Tinker 官方文档:Get Started
- Tinker 官方文档:OpenAI-Compatible API
- Tinker 官方文档:Models & Pricing
- Tinker 官方定价页
- Tinker Playground
核实时间:2026-11-22(Asia/Shanghai)。命令、配置项、体积、硬件要求和 Tinker 标价均据上述官方页面整理,本文未在本地逐项实测。


 微信扫码关注「狠活 AI」


